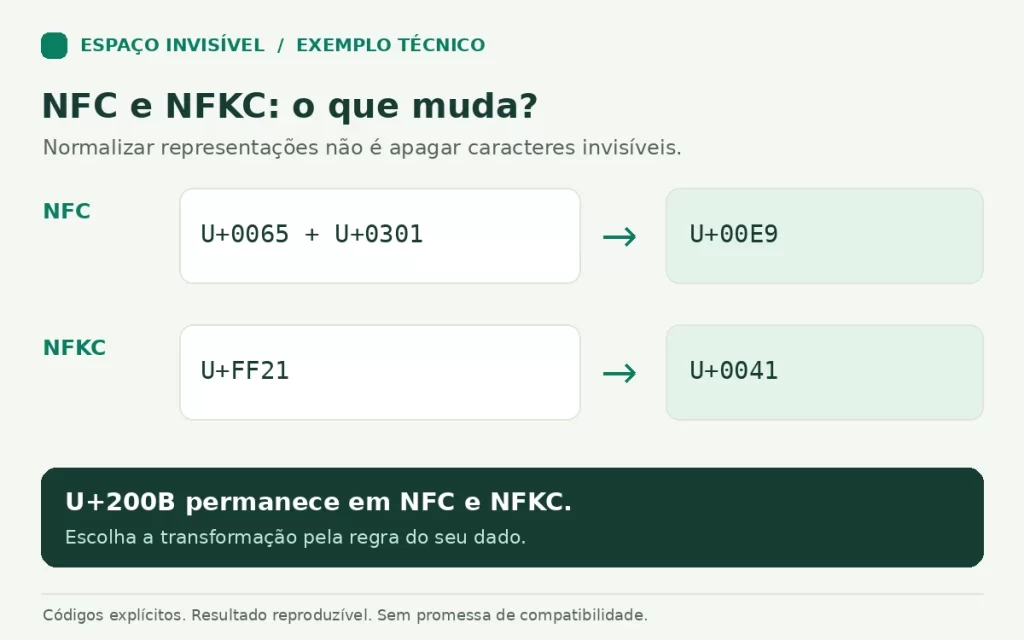
NFC padroniza representações canonicamente equivalentes, como é e e seguido de acento agudo. NFKC também transforma equivalentes de compatibilidade, como A em A. Normalizar não significa remover todos os caracteres invisíveis nem tornar qualquer texto parecido igual.
Este guia resolve uma comparação específica: dois valores parecem iguais na tela, mas uma comparação literal informa que são diferentes. Use os exemplos em uma cópia dos dados.
Por que dois textos iguais na tela podem ser diferentes?
A palavra “café” pode terminar com o ponto de código U+00E9 ou com a sequência U+0065 U+0301. A segunda sequência contém a letra “e” e um acento combinante. A aparência costuma ser a mesma, mas a sequência de pontos de código não é.
Nos exemplos abaixo, a primeira versão tem quatro pontos de código e cinco bytes em UTF-8. A segunda tem cinco pontos de código e seis bytes. Esses números descrevem a representação, não uma quantidade universal de letras visíveis.
| Valor do exemplo | Representação em Python ou JavaScript | Pontos de código | Bytes UTF-8 |
|---|---|---|---|
| café com “é” composto | "caf\u00E9" |
4 | 5 |
| café com acento separado | "cafe\u0301" |
5 | 6 |
A normalização definida pelo Unicode permite comparar representações equivalentes usando uma forma comum. Ela não depende de copiar um espaço em branco.
Qual é a diferença entre NFC e NFKC?
NFC mantém as distinções de compatibilidade; NFKC pode eliminá-las. Ambas fazem uma etapa de decomposição seguida de composição canônica. A diferença é o tipo de decomposição usado.
A tabela mostra resultados reproduzidos nos testes deste guia. “Mantido” significa que o código permaneceu igual ao da entrada.
| Entrada | Resultado em NFC | Resultado em NFKC | Consequência |
|---|---|---|---|
e + acento: U+0065 U+0301 |
é: U+00E9 |
é: U+00E9 |
A sequência passa de dois pontos de código para um |
Hangul Filler: U+3164 |
Mantido | Jungseong Filler: U+1160 |
O caractere muda; ele não é apagado |
NBSP: U+00A0 |
Mantido | Espaço comum: U+0020 |
A distinção de espaço sem quebra é perdida |
A de largura total: U+FF21 |
Mantido | A latino: U+0041 |
A distinção de largura é perdida |
Ligatura “fi”: U+FB01 |
Mantida | fi: U+0066 U+0069 |
Um ponto de código vira dois |
Zero Width Space: U+200B |
Mantido | Mantido | A normalização não remove esse caractere |
Isso explica por que um código pode mudar após um processamento que usa NFKC. Não demonstra que determinado aplicativo aplique essa forma. Para consultar nomes e funções dos caracteres, use a tabela de caracteres Unicode.
Como comparar as duas versões em Python?
Normalize os dois lados da comparação, preservando as entradas originais. O módulo padrão unicodedata fornece a função normalize; não é necessário instalar um pacote adicional.
Salve o exemplo em comparar.py e execute python3 comparar.py:
import unicodedata as ud

a = "caf\u00E9"
b = "cafe\u0301"

print(a == b)
print(len(a), len(b))
print(ud.normalize("NFC", a) == ud.normalize("NFC", b))
print(ud.normalize("NFC", b))
Saída reproduzida:
False
4 5
True
café
O primeiro resultado mostra a diferença literal. O segundo informa os pontos de código de cada entrada. Depois de NFC, os valores comparados coincidem. As variáveis originais continuam disponíveis para conferência.
Como fazer a mesma comparação em JavaScript?
Use String.prototype.normalize() com a forma escolhida. Este exemplo pode ser salvo em comparar.js e executado com node comparar.js:
const a = "caf\u00E9";
const b = "cafe\u0301";

console.log(a === b);
console.log(a.normalize("NFC") === b.normalize("NFC"));
console.log("\u3164".normalize("NFKC").codePointAt(0).toString(16));
Saída reproduzida:
false
true
1160
O último resultado está em hexadecimal: 1160 corresponde a U+1160. Ele confirma a transformação do Hangul Filler neste teste local, sem afirmar como um jogo ou rede social processa o nome de um perfil.
NFC remove espaços invisíveis?
NFC não remove U+200B. NFKC também mantém esse caractere nos exemplos testados. Compare uma sequência com Zero Width Space e outra sem ele:
import unicodedata as ud

texto = "A\u200BB"
print(ud.normalize("NFC", texto) == "AB")
print(ud.normalize("NFKC", texto) == texto)
Saída:
False
True
Se a causa for um caractere adicional, primeiro identifique o código e decida se ele é indevido naquele campo. Transformar representações equivalentes e excluir caracteres são operações diferentes.
Como escolher sem alterar dados importantes?
- Inspecione a diferença. Verifique os pontos de código, não apenas a aparência.
- Defina a equivalência necessária. Para comparar as duas representações de “café”, NFC resolve o caso demonstrado.
- Teste colisões antes de usar NFKC.
A1eA1viram o mesmo valor com NFKC. Isso pode ser desejável em uma busca e inadequado para distinguir dois identificadores. - Preserve o original. Guarde a versão normalizada separadamente quando ela servir apenas como chave de comparação.
- Aplique a mesma regra aos dois lados. Teste também entradas com espaços, acentos combinantes e caracteres de compatibilidade.
O Unicode alerta contra aplicar NFKC indiscriminadamente, pois distinções importantes podem desaparecer. Em senhas, assinaturas, chaves e identificadores, siga o processamento definido pelo sistema responsável. Não altere esses valores por tentativa.
NFC e NFKC também não removem acentos nem ignoram maiúsculas automaticamente: nos testes, é continuou diferente de e, e A continuou diferente de a.
O que foi verificado?
Os exemplos foram executados em 26 de outubro de 2026, com Python 3.12.14, base Unicode 15.0.0, e Node.js 24.22.1, Unicode 17.0. Os resultados mostrados coincidiram nos casos compartilhados.
A verificação cobre comparações de strings e transformações Unicode locais. Não é um teste de aceitação em aplicativos, jogos, bancos de dados ou formulários externos.