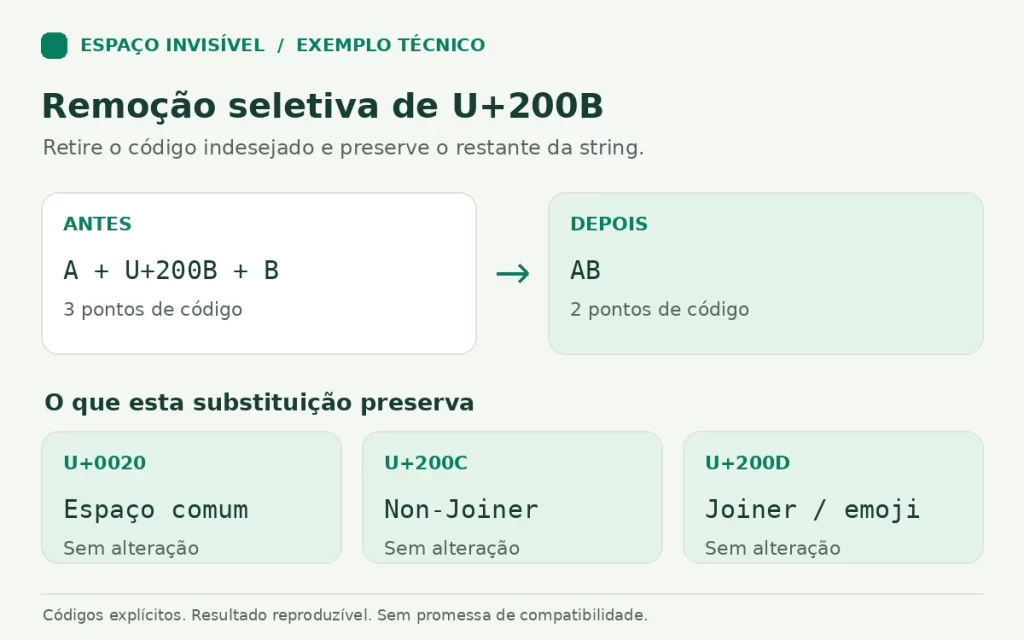
Remova apenas o caractere que você identificou como indesejado e confira o resultado em uma cópia do texto. Apagar tudo que não aparece na tela pode eliminar espaços entre palavras, componentes de emojis e controles necessários à escrita.
Este guia resolve um caso específico: o texto contém um código Unicode conhecido que precisa ser retirado. Se o problema é um caractere que desaparece depois de salvar, consulte o diagnóstico de espaço fantasma.
O que apagar e o que preservar?
A ação depende do código e da função que ele exerce naquele trecho. “Invisível” descreve uma aparência, não uma lista universal de caracteres descartáveis.
| Caractere identificado | Função relevante | Ação neste guia |
|---|---|---|
| U+200B, ZERO WIDTH SPACE | Pode indicar uma oportunidade de quebra sem um espaço visível | Remover somente as ocorrências confirmadas como indesejadas |
| U+0020, SPACE | Separa palavras com um espaço comum | Preservar |
| U+00A0, NO-BREAK SPACE | Separa visualmente e restringe a quebra de linha | Trocar por U+0020 somente quando a separação precisa continuar, mas a restrição não |
| U+200D, ZERO WIDTH JOINER | Participa de sequências de emojis e de outros sistemas de escrita | Preservar, salvo uma correção específica e compreendida |
| U+200C, ZERO WIDTH NON-JOINER | Controla a ligação entre letras em escritas que usam esse recurso | Preservar, salvo uma correção específica e compreendida |
As funções de U+200B e NBSP constam no algoritmo de quebra de linha do Unicode. A especificação de emojis explica a função de U+200D em sequências combinadas. Consulte a tabela de caracteres Unicode para comparar outros códigos.
Como corrigir um trecho curto sem programar?
Redigite o trecho afetado em uma cópia local, depois compare o conteúdo antes de substituir o original.
- Guarde o texto original em um editor local.
- Identifique a palavra ou o campo que contém o caractere indesejado.
- Selecione esse trecho inteiro e digite novamente o conteúdo esperado. Por exemplo, digite
ABse o identificador correto é exatamenteAB. - Preserve os espaços e sinais que pertencem ao conteúdo.
Ana Silvanão deve virarAnaSilva. - Reabra o destino depois de salvar e confira o valor.
O cursor pode percorrer o texto de forma diferente conforme o editor. Por isso, pressionar Backspace “uma vez” não é uma prova de que um determinado código foi removido. Para confirmar a sequência exata, use a inspeção por código do exemplo abaixo.
Não cole senhas, tokens ou dados confidenciais em páginas de diagnóstico. Trabalhe localmente ou use um exemplo fictício que reproduza o problema.
Como remover somente U+200B em Python?
Use replace("\u200b", "") quando todas as ocorrências de U+200B daquele texto já foram revisadas e são indesejadas. O método retorna outra string; a variável original permanece disponível.
Neste exemplo, o valor correto de um identificador é AB, mas existe U+200B entre as duas letras:
original = "A\u200bB"
corrigido = original.replace("\u200b", "")

print([f"U+{ord(c):04X}" for c in original])
print([f"U+{ord(c):04X}" for c in corrigido])
print(corrigido == "AB", len(original), len(corrigido))
Saída verificada:
['U+0041', 'U+200B', 'U+0042']
['U+0041', 'U+0042']
True 3 2
A sequência tem três pontos de código antes da correção e dois depois. O U+200B saiu; A e B permaneceram. Esses números contam pontos de código em uma string Python, não letras visíveis ou posições do cursor.
Dentro de uma string Python, \u200b representa o caractere. Digitar literalmente U+200B em um editor comum escreve o identificador, não o caractere.
A comparação mostra uma transformação de texto reproduzível. Não representa um teste de aceitação em jogos ou aplicativos.
E se apenas uma ocorrência estiver errada?
Remova pela posição confirmada, em vez de substituir todas as ocorrências. O exemplo abaixo remove somente o segundo ponto de código e verifica se ele realmente é U+200B:
original = "A\u200bB\u200bC"
posicao = 2  # Contagem iniciada em 1.
indice = posicao - 1

if not 0 <= indice < len(original):
    raise ValueError("Posição fora do texto.")
if original[indice] != "\u200b":
    raise ValueError("O código nessa posição não é U+200B.")

corrigido = original[:indice] + original[indice + 1:]
print(ascii(corrigido))
Saída:
'AB\u200bC'O segundo U+200B foi preservado. Essa distinção importa quando o mesmo código foi inserido por engano em um lugar, mas tem uma função legítima em outro.
Como tratar um espaço inseparável sem juntar palavras?
Substitua NBSP por um espaço comum somente quando você quer manter a separação e permitir o comportamento normal de quebra:
original = "Ana\u00a0Silva"
corrigido = original.replace("\u00a0", " ")
print(corrigido)
Saída: Ana Silva. Substituir por uma string vazia produziria AnaSilva, que é outro conteúdo. Esta troca também altera a regra de quebra de linha; não a aplique a documentos que precisam manter as palavras juntas.
Por que evitar filtros que removem tudo?
Um filtro genérico pode modificar mais conteúdo que o necessário. No teste local, remover toda a categoria Unicode Cf também retirou os três U+200D da sequência familiar 👨👩👧👦. A sequência resultante passou de sete para quatro pontos de código. A apresentação visual depende da fonte e do aplicativo.
A substituição exclusiva de U+200B preservou integralmente essa sequência, um exemplo persa com U+200C, espaços comuns, quebras de linha, tabulações e seletores de apresentação.
strip() também não é um removedor universal: aplicado ao exemplo \u200bAB\u200b, deixou os U+200B nas duas extremidades. Já a expressão Python re.sub(r"\s+", "", texto) retirou espaços comuns e quebras de linha do exemplo A B\nC, mas preservou U+200B em A\u200bB.
Como confirmar que a correção terminou?
Compare os códigos antes e depois, confira o conteúdo legível e teste o campo de destino. A ausência do código escolhido comprova sua remoção daquela string. Não comprova que um aplicativo aceitará o resultado.
Os exemplos foram executados em 26 de outubro de 2026, com Python 3.12.14 e base Unicode 15.0.0. Os testes avaliaram strings locais, sem alterar contas, nomes ou mensagens em serviços externos.
Fontes de implementação: métodos de strings do Python e consulta de propriedades com unicodedata. A documentação Unicode sobre caracteres não exibidos distingue espaços, controles e caracteres ignoráveis na apresentação.