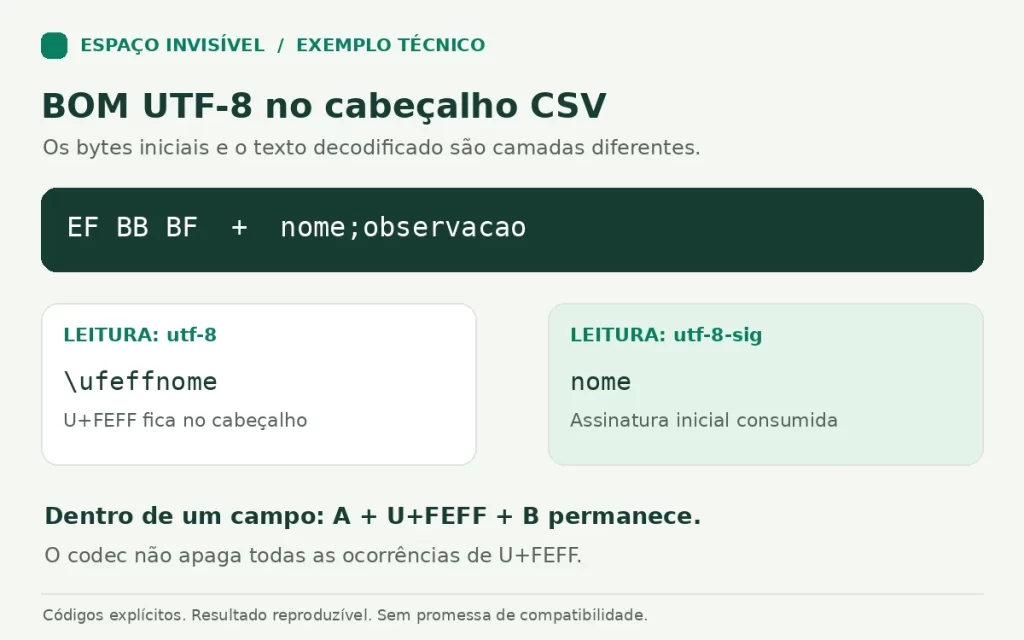
Um BOM UTF-8 pode virar U+FEFF no primeiro cabeçalho quando o leitor não trata a assinatura do arquivo. No Python, um CSV conhecido como UTF-8 pode ser aberto com encoding="utf-8-sig": esse codec consome a assinatura inicial, quando presente, sem remover o restante do texto.
O sintoma é específico: você enxerga a coluna nome, mas uma busca por linha["nome"] falha. Antes de renomear colunas ou apagar caracteres do arquivo inteiro, confira os bytes iniciais e o valor real do cabeçalho.
Como o BOM entra no nome da coluna?
O BOM, abreviação de Byte Order Mark, usa os bytes EF BB BF no início de um fluxo UTF-8. Nesse formato, ele funciona como assinatura de codificação; não indica uma ordem alternativa dos bytes. UTF-8 também pode existir sem BOM, conforme explica a referência do Unicode sobre BOM.
Na leitura do nosso exemplo com utf-8, esses três bytes produziram o ponto de código U+FEFF. Como o arquivo começou por nome;observacao, a primeira chave passou a ser "\ufeffnome". Essa chave é diferente de "nome", embora a diferença possa não aparecer na tela.
Como reproduzir e confirmar o problema?
O exemplo abaixo cria um CSV temporário, lê o mesmo arquivo de duas maneiras e apaga apenas a pasta temporária ao terminar. Ele não altera seus arquivos de trabalho. Requer Python 3.
from pathlib import Path
from tempfile import TemporaryDirectory
import codecs
import csv

texto = (
    'nome;observacao\r\n'
    'Ana;ação\r\n'
    'João;"São Paulo; SP\r\nentrega manhã"\r\n'
    'Bia;"A\ufeffB"\r\n'
)

with TemporaryDirectory() as pasta:
    arquivo = Path(pasta) / "exemplo.csv"
    arquivo.write_bytes(codecs.BOM_UTF8 + texto.encode("utf-8"))
    print(arquivo.read_bytes()[:3].hex(" ").upper())

    for codificacao in ("utf-8", "utf-8-sig"):
        with arquivo.open(encoding=codificacao, newline="") as f:
            leitor = csv.DictReader(f, delimiter=";")
            linhas = list(leitor)
            print(codificacao, repr(leitor.fieldnames[0]))
            print("chave nome existe:", "nome" in linhas[0])
Saída obtida com Python 3.12.14:
EF BB BF
utf-8 '\ufeffnome'
chave nome existe: False
utf-8-sig 'nome'
chave nome existe: True
repr() mostra o escape \ufeff, tornando a diferença visível. A tentativa de acessar linhas[0]["nome"] na leitura com utf-8 gerou KeyError no teste; com utf-8-sig, o valor foi Ana.
Para investigar seu próprio arquivo, substitua a criação temporária por um caminho local. Primeiro confirme com o exportador que o conteúdo é UTF-8. Uma extensão .csv não informa a codificação nem o separador.
Como ler o CSV sem alterar o original?
Abra o arquivo em modo de leitura e informe o separador real. Neste exemplo, as colunas usam ponto e vírgula:
import csv

with open("dados.csv", encoding="utf-8-sig", newline="") as f:
    leitor = csv.DictReader(f, delimiter=";")
    print([repr(coluna) for coluna in (leitor.fieldnames or [])])
    for linha in leitor:
        print(linha["nome"])
A documentação do codec utf-8-sig descreve o tratamento da assinatura inicial. A configuração newline="" e o processamento de campos entre aspas fazem parte da leitura com o módulo csv. Não troque esse processamento por split(";"): o nosso campo "São Paulo; SP" contém um ponto e vírgula que pertence ao valor.
Se o código acusar UnicodeDecodeError, confirme a codificação na origem. Usar errors="ignore" para esconder o erro pode descartar bytes e produzir dados incompletos.
O que permaneceu igual depois da leitura?
Executamos o arquivo sintético em Python 3.12.14, em 26 de outubro de 2026. Estes foram os resultados; eles verificam o processamento em Python, não a interface de uma planilha.
| Elemento testado | Resultado com utf-8-sig |
|---|---|
| Primeiro cabeçalho com BOM | nome, sem U+FEFF inicial |
| Texto com acentos | ação, sem mudança |
| Separador dentro de aspas | São Paulo; SP, dentro do mesmo campo |
| Quebra de linha dentro de aspas | \r\n preservado no valor |
U+FEFF dentro de outro campo |
A\ufeffB, preservado |
| Mesmo CSV sem BOM | Cabeçalho nome, sem perder a letra n |
| Quantidade de registros | Três registros de dados nas duas leituras |
O teste explica por que texto.replace("\ufeff", "") não é uma correção equivalente: a substituição global também apagou o U+FEFF inserido no campo de Bia. Tratar uma assinatura inicial e limpar o conteúdo de uma célula são operações diferentes. Para comparar esse código com outros caracteres, consulte a tabela de caracteres Unicode invisíveis.
E se o sistema exigir um arquivo sem BOM?
Crie outra cópia somente depois de confirmar esse requisito. O trecho abaixo valida a leitura UTF-8 e remove apenas os três bytes iniciais identificados. O modo "xb" impede sobrescrever um arquivo de destino que já exista.
from pathlib import Path
import codecs

origem = Path("dados.csv")
destino = Path("dados-sem-bom.csv")
dados = origem.read_bytes()

if not dados.startswith(codecs.BOM_UTF8):
    raise SystemExit("O arquivo não começa com BOM UTF-8.")

dados.decode("utf-8-sig")  # Falha se o restante não for UTF-8 válido.
with destino.open("xb") as f:
    f.write(dados[3:])
Nesse teste, a cópia diferiu do original apenas pelos três bytes iniciais. O arquivo de origem permaneceu intacto. Para arquivos grandes, esse exemplo exige memória para carregar todo o conteúdo; ele é uma receita simples para arquivos que cabem na memória disponível.
BOM, acentos corrompidos e separador errado são o mesmo erro?
Não. Confira cada camada antes de modificar os dados:
- Cabeçalho
\ufeffnome: examine a assinatura no começo do arquivo e o codec usado na leitura. - Texto como
ação: investigue a codificação usada na exportação e na leitura. Remover o BOM não recupera automaticamente texto já corrompido. - Uma coluna chamada
nome;observacao: confirme o delimitador. No nosso teste, ler um arquivo separado por;comdelimiter=","manteve esse cabeçalho inteiro. - Uma célula visualmente vazia que afeta fórmulas: o problema pode estar no conteúdo da célula, não na assinatura do arquivo. Veja o diagnóstico de espaços em branco no Word e Excel.
Antes de importar a cópia em outro sistema, confira os nomes das colunas, os acentos e a quantidade de registros. A correção do BOM resolve a assinatura inicial; não valida todas as regras do sistema que receberá o CSV.