O mesmo texto pode ter contagens diferentes porque cada contador mede uma unidade. JavaScript usa unidades UTF-16 em length; outro contador pode medir pontos de código, agrupamentos de grafemas ou bytes. Antes de comparar um resultado com o limite de um campo, identifique a unidade usada pelo aplicativo.
O analisador de caracteres deste site conta pontos de código. Um caractere sem desenho visível também entra nessa contagem.
O que cada medida conta?
| Medida | O que está sendo contado | Para que serve neste diagnóstico |
|---|---|---|
| Unidades UTF-16 | Unidades da representação usada pelas strings JavaScript | Entender o resultado de texto.length |
| Pontos de código | Valores Unicode presentes na sequência | Identificar componentes, inclusive invisíveis |
| Agrupamentos de grafemas | Segmentos definidos por regras de segmentação | Aproximar unidades percebidas pelo usuário |
| Bytes UTF-8 | Bytes produzidos ao codificar o texto em UTF-8 | Entender o tamanho nessa codificação |
Grafema e desenho na tela não são a mesma coisa. Fonte, composição e renderização influenciam a aparência. As regras de segmentação Unicode explicam essa distinção.
Como as contagens mudam em exemplos reais?
Os rótulos abaixo identificam as sequências; o texto dos rótulos não entra na contagem.
| Texto analisado | UTF-16 | Pontos de código | Grafemas | Bytes UTF-8 |
|---|---|---|---|---|
| Texto vazio | 0 | 0 | 0 | 0 |
| U+3164 isolado | 1 | 1 | 1 | 3 |
| U+200B isolado | 1 | 1 | 1 | 3 |
| é como U+00E9 | 1 | 1 | 1 | 2 |
| e + acento U+0301 | 2 | 2 | 1 | 3 |
| 😀 como U+1F600 | 2 | 1 | 1 | 4 |
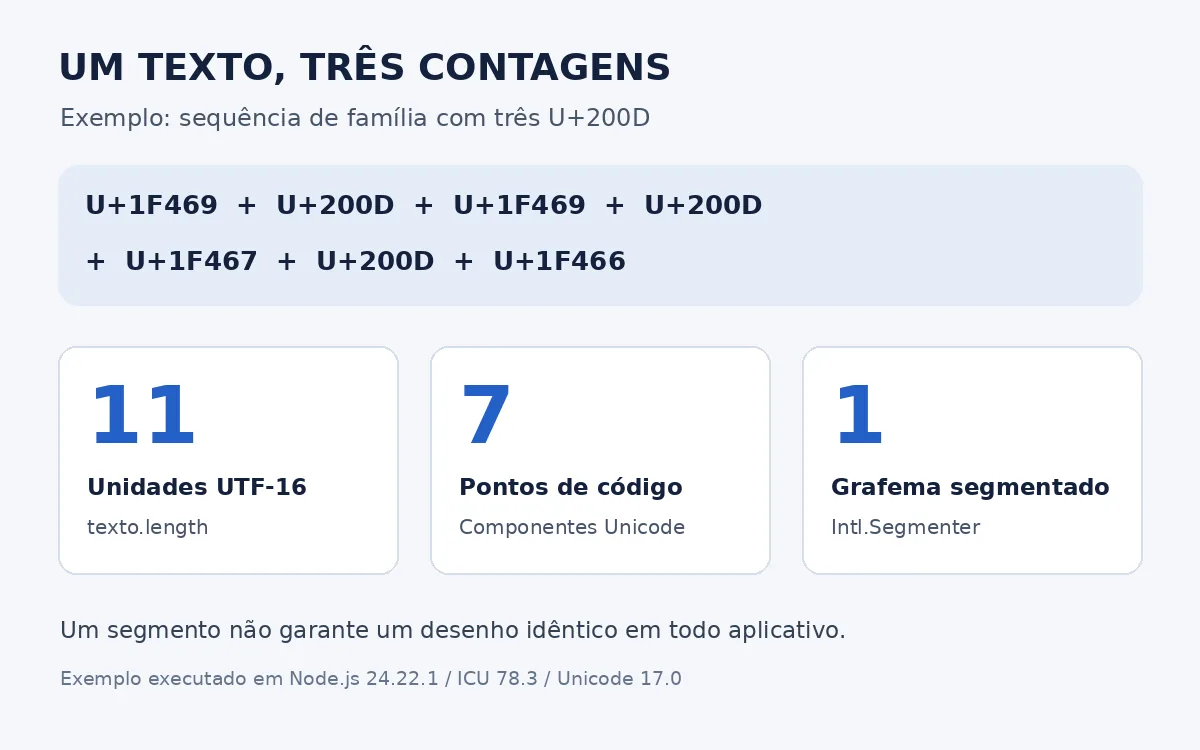
| 👩👩👧👦 nesta sequência | 11 | 7 | 1 | 25 |
U+200B continua sendo um segmento mesmo sem largura própria. Portanto, “1 grafema” não significa “1 símbolo visível”.
Por que a família usa sete pontos de código?
Neste exemplo, quatro componentes de pessoas são conectados por três U+200D, chamados ZERO WIDTH JOINER. A sequência completa é:
U+1F469 U+200D U+1F469 U+200D U+1F467 U+200D U+1F466
Ela foi segmentada como um agrupamento no ambiente de teste. Isso não garante que qualquer aparelho a desenhe da mesma forma. Apagar os joiners altera a sequência; consulte a diferença entre emoji e caractere em branco antes de tratar todos os códigos invisíveis como resíduos.
Como reproduzir a comparação em JavaScript?
Use um ambiente que ofereça Intl.Segmenter e TextEncoder. O exemplo apenas lê as strings e devolve as contagens.
const segmentador = new Intl.Segmenter("pt-BR", {
  granularity: "grapheme"
});

function contar(texto) {
  return {
    utf16: texto.length,
    pontosDeCodigo: [...texto].length,
    grafemas: [...segmentador.segment(texto)].length,
    bytesUtf8: new TextEncoder().encode(texto).length
  };
}

console.log(JSON.stringify(contar("e\u0301")));
console.log(JSON.stringify(contar(
  "\u{1F469}\u200D\u{1F469}\u200D\u{1F467}\u200D\u{1F466}"
)));
Resultado observado:
{"utf16":2,"pontosDeCodigo":2,"grafemas":1,"bytesUtf8":3}
{"utf16":11,"pontosDeCodigo":7,"grafemas":1,"bytesUtf8":25}
As referências são a especificação de strings ECMAScript e a definição de Intl.Segmenter.
Essa contagem revela o limite de um aplicativo?
Ela revela as medidas do texto neste teste. Para saber se o destino aceita a entrada, confira a regra daquele campo e seu resultado após salvar. Um limite anunciado em “caracteres” pode usar outra contagem ou aplicar transformações.
Não retire acentos ou componentes de emojis apenas para fazer dois contadores concordarem. Se duas palavras parecem iguais, mas usam sequências diferentes, veja quando usar NFC ou NFKC. Se há um código realmente indesejado, siga a remoção seletiva de caracteres invisíveis.
O que foi verificado?
As contagens da tabela foram executadas em Node.js 24.22.1, ICU 78.3 e Unicode 17.0, em 27 de outubro de 2026. A segmentação pode variar conforme a implementação e os dados Unicode usados pelo ambiente. Não foi realizado teste de aceitação em redes sociais, jogos ou interface do iPhone.
Para consultar os nomes e funções dos códigos, use a tabela Unicode do site.